
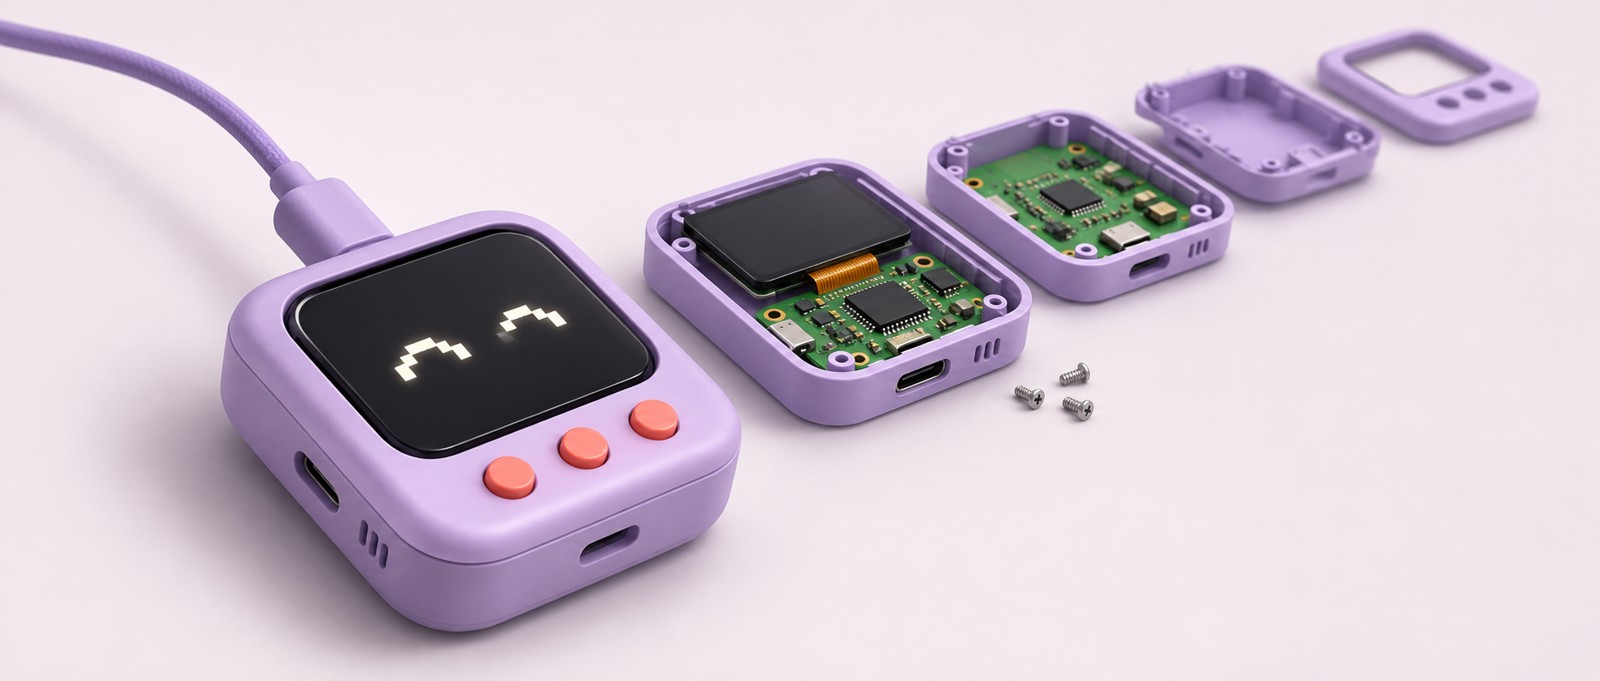
两个人,用不到一周设计一台能和Codex对话的小设备。外壳、电路板、界面、固件,都交给模型参与完成。
这次交付的不只是一张效果图,后面真的有工厂接单。
但OpenAI在11月3日公布这个试验时,也写了后半段:代工厂不到一个月做出小批原型;进入制造前,仍然经过多轮审查和修改。模型没有稳定考虑好工厂的生产限制、公差与装配细节。
但“设计完成”,还没有得到工厂的最后认可。
一台样机,过了哪些关?
这个设备值得关注,因为它把几种通常分开进行的工作串到了一起:外壳要装得下电路板,元件和连接要适应空间,界面与固件还得驱动真实硬件。
对一个只有想法的人,跨过这些工具和文件格式的门槛,本来就不容易。模型如果能帮助协调这些工作,第一台样机的起点会改变。
但不要把几个验收阶段压成一个“成功”。
设计文件能打开,是文件有效;规则检查通过,是没有触发当前配置的规则;装配后能启动,是某台样机工作;不同批次持续达到要求,才开始涉及更完整的交付能力。
前一关通过,不能替后一关签字。一块板子点亮了,不能顺手推出它能稳定量产;一个漂亮外壳能打印出来,也不说明换一种工艺后仍然合适。
判断AI硬件演示时,最先该找的,是它把“完成”停在哪一关。
12分钟布完线,究竟是谁在算?
另一份来自NextPCB的测试,把这个问题拆得更细。
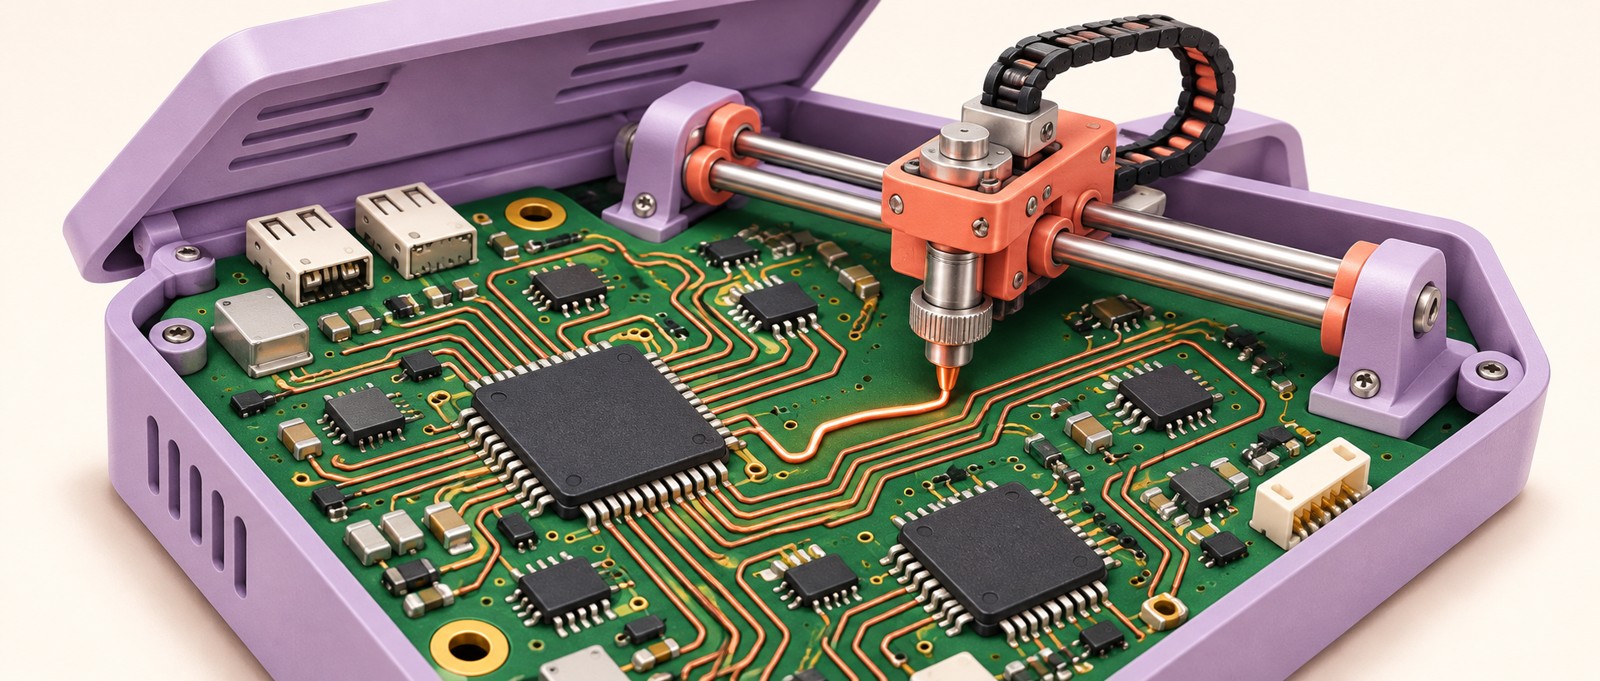
测试从一块元件已经摆好的电路板开始。允许使用外部工具时,Astra约12分钟拿到布线结果,走的是KiCad导出、Freerouting自动布线、再导回KiCad的流程。限制为只通过KiCad界面操作后,另一次运行一小时仅完成三段短走线,随后被人工停止。
这只是同一块板上的两次测试,不能当成模型布线能力的普遍结论,也不能据此推断OpenAI原演示的实现。
不过,区分工作是谁完成的,仍然很重要。调用一个专业求解器,与模型自己找到布线方案,说明的是两种能力。
工具调用并不减损自动化的价值。工程师本来也不需要徒手替代每一个求解算法。把文件在正确的格式之间转换、把约束传给合适的工具,再把结果带回来,可能就能省掉不少重复劳动。
但这份能力应该按“工作流能否可靠跑通”来评价。求解器算出的线路质量,不能全记在语言模型的推理能力上;模型会开软件,也不能推出它理解了所有电气约束。
对采用者来说,知道能力落在哪一层,才能判断出错后应该换模型、换工具,还是补规则。
一把螺丝刀,也是设计约束
为什么看起来完整的设计,到了工厂还要改?
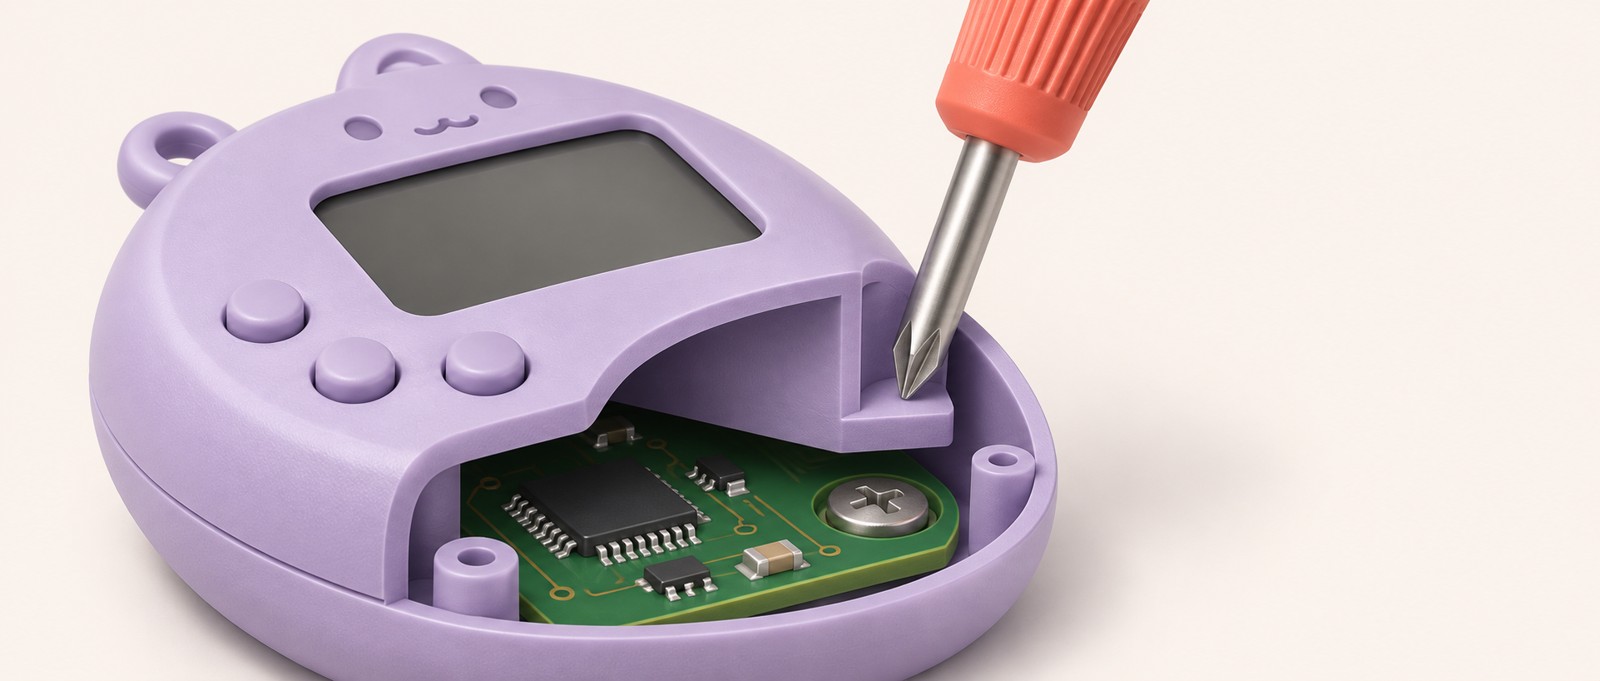
假设电路板放得进去,固定它的螺丝也有位置,但装上另一块零件后,螺丝刀伸不进去。几何上没有重叠,装配顺序却出了问题。
再比如,两个零件的名义尺寸刚好相配,实际制造都会有偏差。把它们分别做到图纸允许的边缘时,还能不能装起来?仅看理想模型,答案不会自动出现。
这些是假设例子,并不是那台电子宠物被披露的具体故障。它们说明,制造要求不仅是“画得出来”,还包括工艺、偏差、装配、检查和返修。
如果这些要求没有进入设计输入,模型就可能交出一份在已知条件下很合理、但遗漏现场条件的方案。
反过来,只说“让AI再聪明一点”也不够具体。工厂能提供什么约束,工具能检查什么,哪些结果必须回到实物上验证,都会影响最终效果。
硬件开发,最怕把返工藏到下一轮
软件里修改一段代码,再跑一次测试,通常不需要等新的零件到货。硬件一旦进入制作,修改可能牵动采购、加工、装配与交付时间。
只报“画图从几天变成几小时”,容易漏掉后面的账。
如果生成速度提高后,团队一次提交了更多没有经过充分检查的版本,厂里的返工不一定减少。设计端省下的时间,也可能只是被转交给后面的工程师。
更有用的记录,是从第一份设计到可用样机之间,发生了几次修改,哪些修改来自制造问题,以及人花了多少时间排查和确认。
有了这些信息,才能判断AI是在缩短开发周期,还是只把第一份文件交得更快。
对想用AI试做硬件的团队,可以从约束清楚、容易测试的小项目开始。先定义通过条件,让模型整理检查项,再请专业人员核查关键设计,最后用实物结果修正下一版。
电子宠物的演示已经说明,通用模型可以把跨工具的设计推得很远。它还没有回答的是:这种能力能在多少种项目中稳定复现,交付前还需要多少人工工作。
我更愿意等到下一次演示里,除了成品,还能看到一份返工清单。那张不太好看的表,往往更接近AI改变硬件开发的真实程度。
评论区