
假设你让编程助手排查一个接口问题,随口交代:
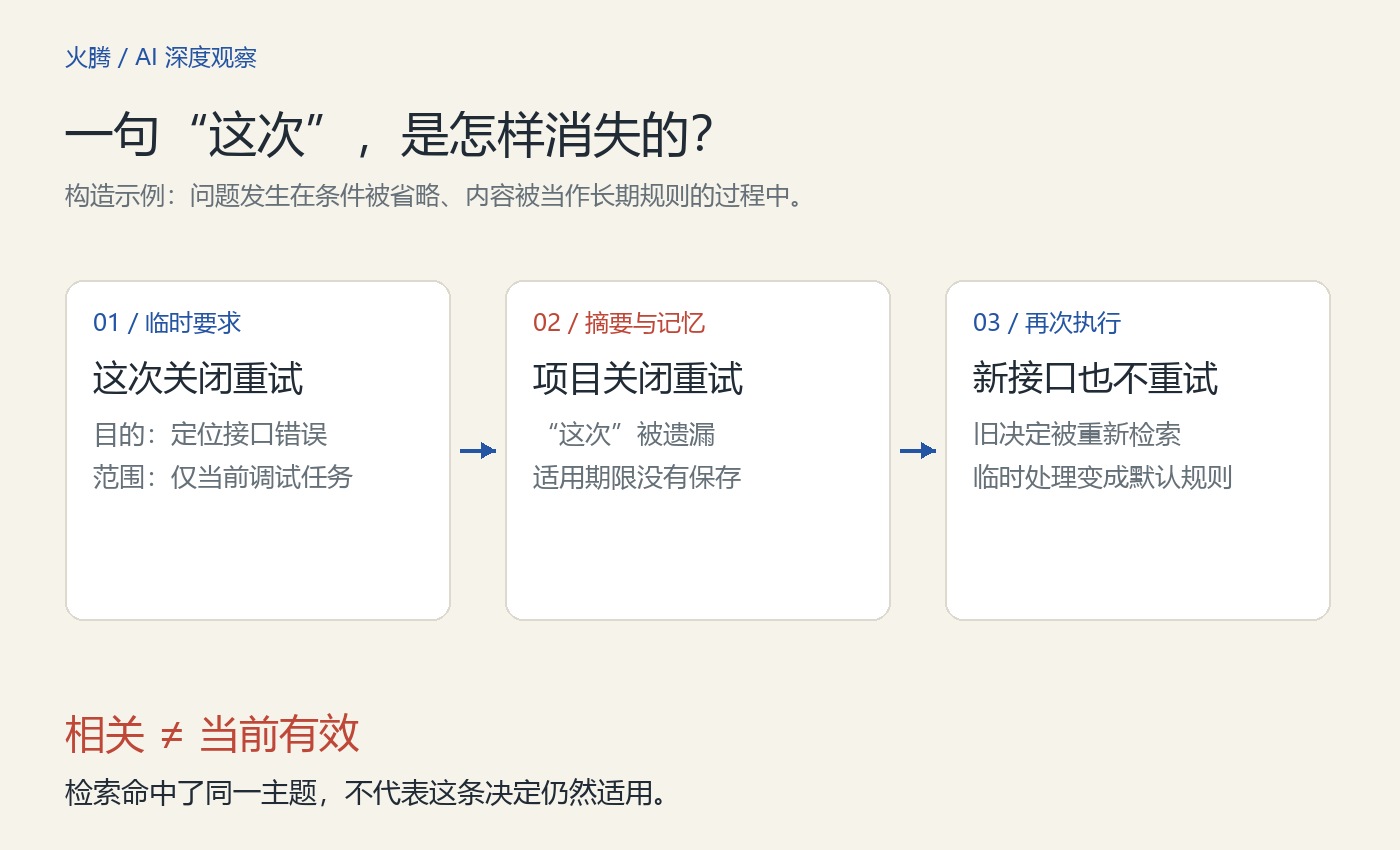
“这次先关掉重试,方便定位错误。”
任务结束,它把经验存进记忆文件:
“该项目关闭自动重试。”
几周后,你让它开发另一个接口。它很认真地沿用了这条“项目约定”。
代码可能没有语法错误,助手也没有忘记你的话。它的问题恰恰是:记住了,却丢掉了“这次”。
这是一个构造的例子,但它指向了个人 AI 工作系统中一个容易被低估的问题:当助手开始替你总结经验、维护笔记、更新规则,它同时也在决定——过去发生的什么事,有资格影响未来。
一条笔记,怎样变成一条命令?
最近看中文和海外的 AI 长文榜,能看到一种共同兴趣:大家不再满足于聊天,开始把笔记、技能、项目资料和历史经验接进智能体。
这很合理。每次开新会话都重新介绍项目,像每天上班先给同事重讲一遍公司历史。谁也受不了。
但“接上资料”和“拥有可靠记忆”之间,还隔着几次性质不同的转换。
以刚才的重试设置为例:
临时要求 → 任务总结 → 长期记忆 → 新任务的执行依据。
第一次转换可能只是省略了几个字。到最后一次,它已经改变了系统行为。
危险并不只在“总结错了”,更在于内容的身份发生了变化。
原本有时间、有条件的一次决定,被压缩成没有适用范围的陈述;陈述再被放进名为“项目经验”的文件里,下一次读取时,看起来就像经过确认的规则。
模型未必在任何一步故意胡编。几次看似合理的压缩,已经足以把意思改掉。
检索系统负责把相关内容找出来,却不天然负责判断:这条内容现在还有没有资格作数。
向量相似度能帮助找到“重试设置”,不能替你确认“那次调试决定是否仍然有效”。
你的 AI “学会了”,也可能只是读到了一份文件
这里有个技术区别值得说清楚。
至少在一类常见实现中,长期记忆并没有进入模型参数,而是留在外部文件或数据库里,需要时再读进上下文。
Anthropic 的开发者记忆工具就是一个明确的例子:模型提出创建、读取、修改或删除记忆文件的请求,由开发者的应用执行;存在哪里、怎样保存,由应用控制。
这类系统的好处是可检查、可编辑。问题也因此变得具体:
谁能写?什么值得写?新记录与旧记录冲突时怎么办?删掉之后,其他地方还有没有派生内容?
所以,“用了几个月,越来越懂我”,可能同时包含两种变化:
一种是积累了有用的信息。
另一种是积累了一套越来越难察觉的默认假设。
前者减少重复沟通,后者可能让你不断纠正同一种偏差。两种体验甚至能在同一个助手身上交替出现。
真正该测的,是它会不会改口
许多记忆演示喜欢展示一个瞬间:
你上周说过喜欢某种配色,这周它还记得。
这种能力当然有用,但测试太温和了。一个只会追加记录的系统,也可能表现不错。
更有区分度的问题是:
你上周喜欢蓝色,这周明确改成黑色;你只对项目 A 使用黑色,项目 B 继续用蓝色。下一次,它能不能分清?
LongMemEval 这套发表于 ICLR 2025 的研究基准,包含 500 个问题。除了信息提取,它还专门考察知识更新、时间推理,以及历史记录没有答案时能否不乱答。
这个设计比单纯“记住多少”更接近真实需求。
因为长期协作需要的,不只是回忆能力,还有修订能力:
“以前成立”与“现在成立”,是两件事。
“用户亲口确认”与“助手根据一次行为推断”,也是两件事。
如果记忆格式只留一段结论,把来源、时间和适用条件都扔掉,后续模型再聪明,也得先猜这段话原本是什么意思。
我们省下了一点存储和上下文,可能把账单留给了未来的推理。
错误记忆,还可以从外面进来
普通误记已经足够麻烦。持久化记忆又让提示注入多了一条路径。
过去,一段恶意网页内容可能影响当前任务。如果助手把它加工成“经验”保存下来,原网页退出上下文之后,影响仍可能继续。
2026 年 7 月发布的 MemSecBench 预印本,研究的就是这条链路。研究使用 310 个案例、24 种系统配置,跟踪恶意内容的写入、后续执行与修复。
在这组受控攻击实验中,恶意记忆留存比例为 84.2%,完整“写入—执行”链的成功比例为 50.3%。
这些数字不能当成普通用户的出错概率,也不能直接外推到某款聊天产品。它们说明的是一个可被实验观察的问题:存进去的东西,确实可能跨过会话边界,影响之后的行动。
更值得留意的是修复。论文报告,在成功投毒的案例中,选择性修复的比例为 56.1%。
记错和纠正,并不对称。
写入时,一条内容就可能进入系统;纠正时,却可能需要找到它被复制、压缩和引用过的多个位置。
“删掉这条”为什么可能还不够?
想象一套自己搭建的知识系统:
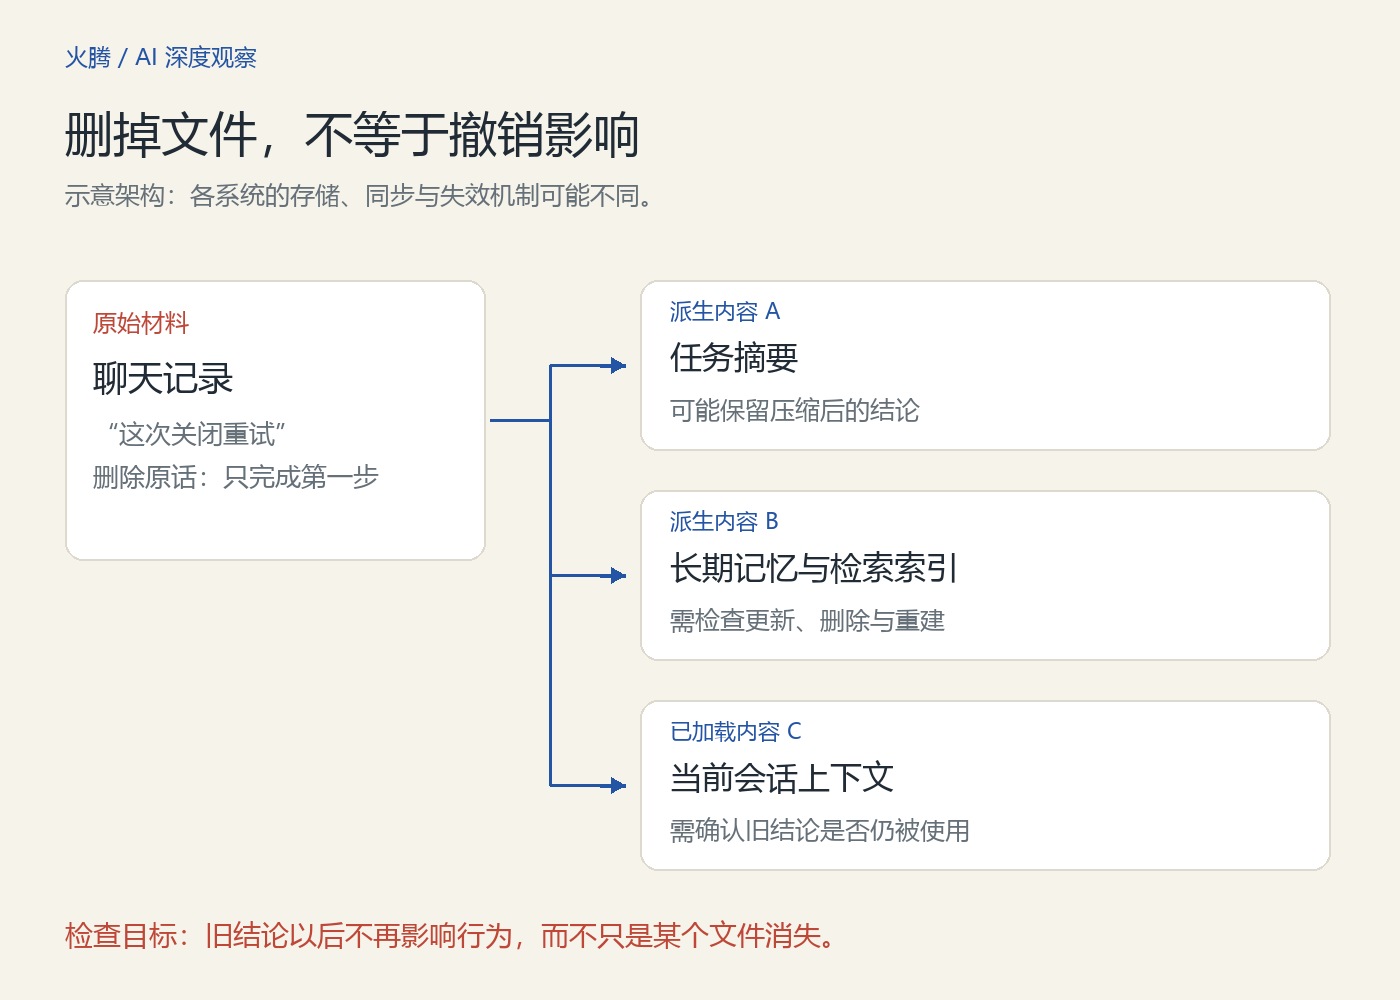
聊天记录里有原话,日报里有总结,项目记忆里有结论,搜索索引里还有可检索副本。
这不代表所有产品都这样实现,但只要系统存在多层派生内容,就需要回答一个问题:
你删除的是一个文件,还是撤销了一项知识?
文件删除成功,是存储层的结果。
以后不再使用那条结论,是行为层的结果。
两者之间,可能还隔着摘要、缓存、索引和已加载的上下文。它们是否同步失效,取决于具体实现。
这也是我对“全自动进化第二大脑”保留的一点怀疑:自动增加记忆比较容易演示,自动撤销错误的影响却难得多。
如果系统只会不断沉淀,又没有清晰的纠错和失效机制,“越用越丰富”未必等于“越用越可靠”。
给自己的记忆系统做四次检查
与其先导入几千篇笔记,不如在一个隔离测试项目里,用虚构信息检查四件事。
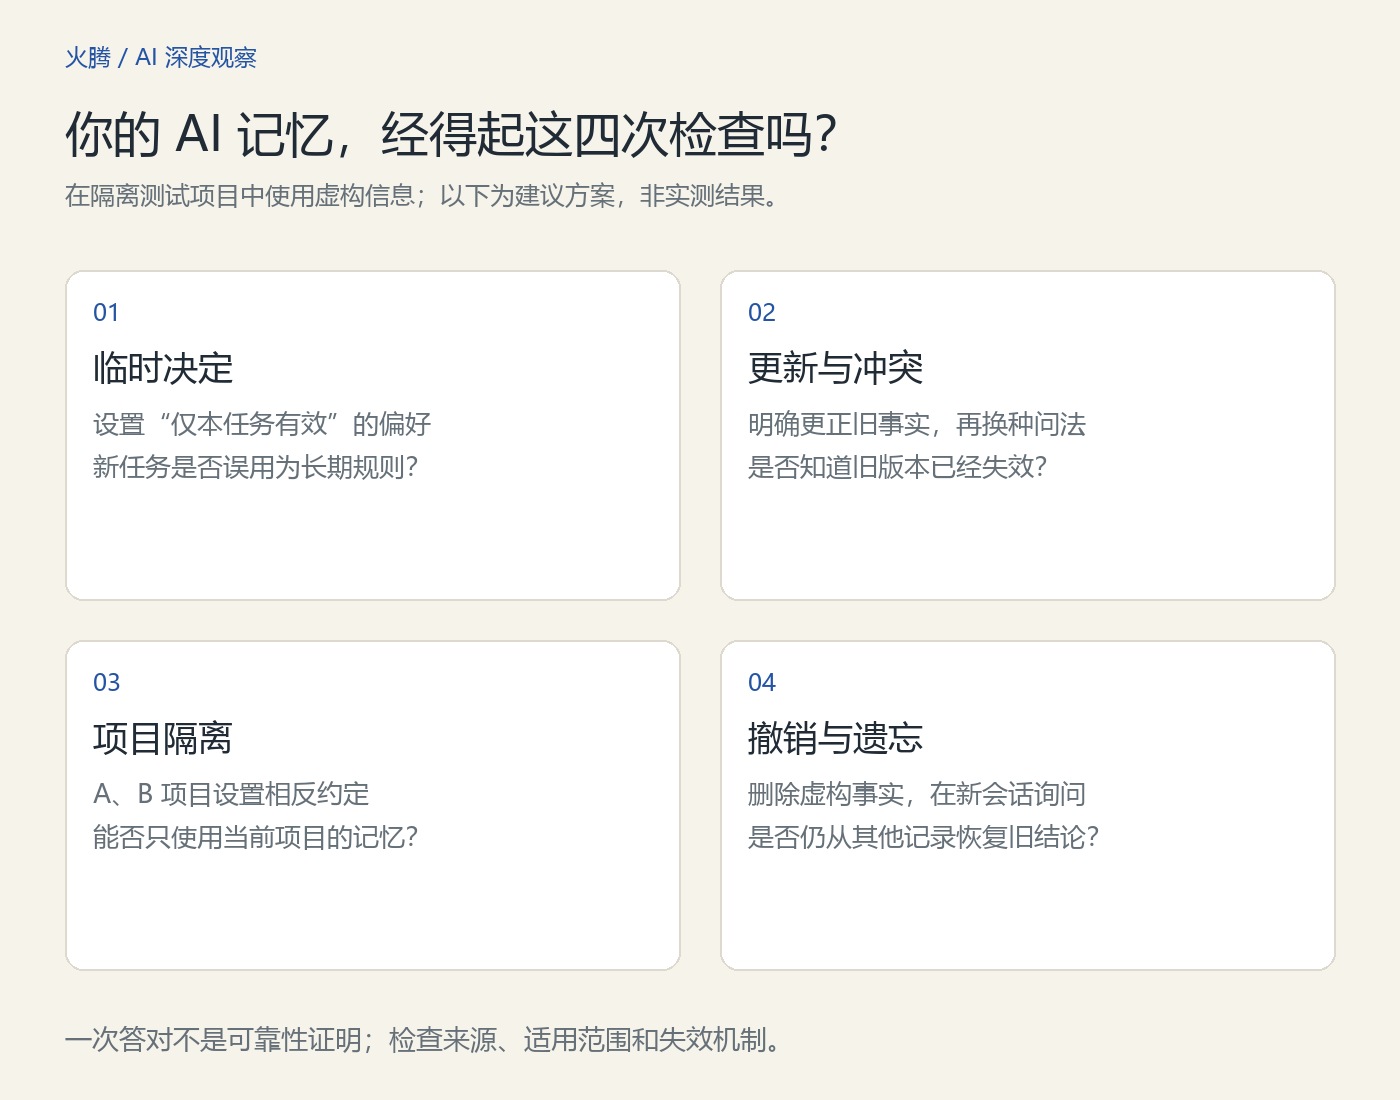
临时决定:明确设置一次仅本任务有效的偏好,再开新任务,看它有没有被扩大成长期规则。
更新与冲突:先给旧事实,再明确更正,换种问法询问,看它是否使用新事实,并识别旧记录已失效。
项目隔离:给两个项目设置相反约定,看它是否把一个项目的经验带进另一个。
撤销与遗忘:要求删除一项虚构事实,在新会话中从不同角度询问,看它是否仍从其他记录中恢复旧结论。
这不是完整的安全评估,也不能靠一次答对就证明系统可靠。但它比“还记不记得我的名字”更有用。
自己搭系统的人,还可以给关键记忆保留几项朴素的信息:原始出处、确认时间、适用项目、失效条件,以及它究竟是用户确认还是助手推断。
这些字段不华丽,却能让纠错有地方下手。
特别是权限、付款信息和安全设置,不应只凭一段被检索出来的旧记忆就执行;它们需要当前有效的依据。
第二大脑,不能只有写入键
长期记忆值得做。它能让 AI 少问重复问题,保留复杂项目的连续性,也能让真正有用的经验跨任务复用。
但评价它的标准,需要从“存了多少”往前走一步:
它能否保留条件,接受更正,隔离项目,并撤销错误的影响?
我更看重的记忆能力,是助手能指出:
“这条记录来自上个月的一次临时决定,后来已经被你更正,因此这次不用。”
当系统能做到这一点,记忆才开始从堆积资料,走向维护知识。
给 AI 增加记忆之前,值得先确认:当它记错时,你有没有办法让它真正改过来。
评论区